Az emberihez hasonló „álmodással” kísérletezik az Anthropic az AI-ügynökeinél
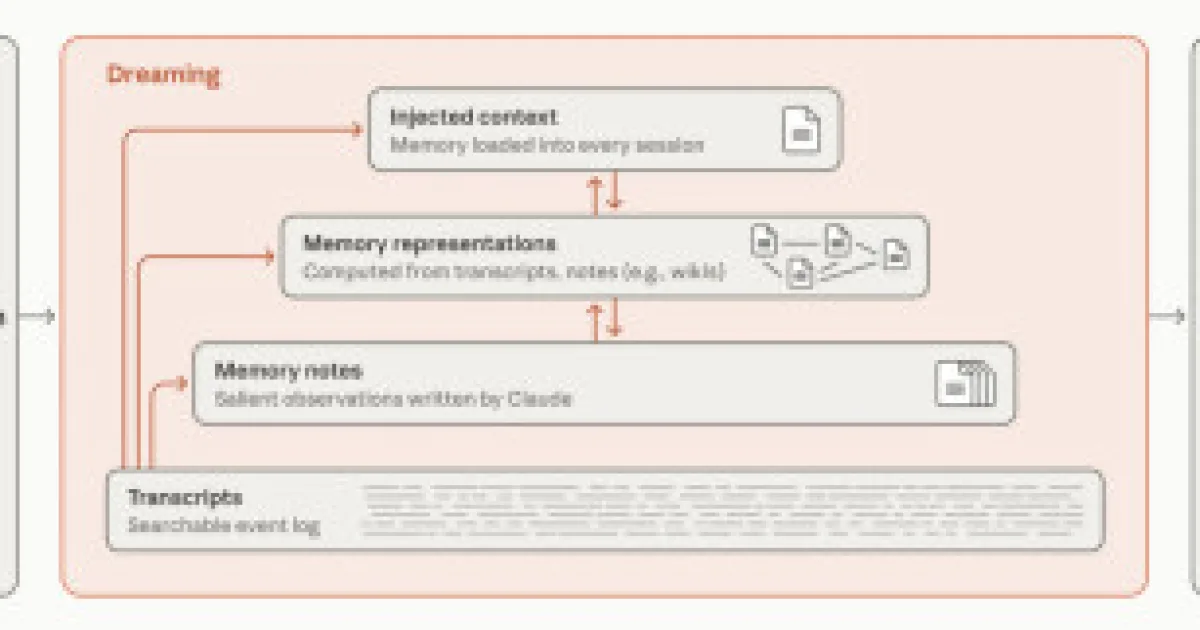
Az Anthropic legújabb kutatásában azt vizsgálja, miként képes a Claude nevű nyelvi modell az üresjárataiban áttekinteni a korábbi tapasztalatait, kijavítani a tévesen rögzített „emlékeit”, és rendszerezni azokat a későbbi beszélgetésekhez. A fejlesztők ezt a folyamatot az emberi „álmodáshoz” hasonlították, amely az agy memóriarögzítéséhez járul hozzá.
A módszer segítségével a mesterséges intelligencia a tétlen időszakokban kiszűri a hibás információkat, pontosítja a jegyzeteit és strukturált tudásbázist épít, ami jelentősen javítja a teljesítményét az összetett, hosszan tartó feladatok során.
Az Anthropic által közzétett kutatás szerint az AI-alapú ügynökrendszerek működésének egyik legnagyobb kihívása annak eldöntése, hogy mit érdemes megőrizniük a modelleknek a memóriafájljaikban. Az ügynökök a működésük során rengetek dokumentációt készítenek saját maguk számára, amiben gyakran megpróbálnak minden apró részletet rögzíteni. Ezáltal azonban sokszor egy átláthatatlan adathalmaz jön létre, a technika pedig egyszerre hordozza magában annak veszélyét, hogy egy-egy fontos kontextus kimarad a feljegyzésekből, vagy éppen elavult adatok maradnak benne, ezek pedig rontják a rendszerek hatékonyságát.
A Claude-ot fejlesztő cég elemzése szerint az emberi álmodáshoz hasonló, „üresjáratokban” végzett memóriaszelektáló folyamatok megoldást jelenthetnek erre a problémára.
A kutatók a Pokémon Red videójátékkal tesztelték ezt a problémát, amelyben két modell teljesítményét vetették össze, körülbelül tízezer, a játékban tett lépés után. Míg a tavaly év elején bemutatott Sonnet 3.7 modell szinte mindent feljegyzett – több mint négyszáz fájlban közel egymillió karaktert halmozva fel –, mindössze egyetlen jelvényt tudott megszerezni a játékban. Ezzel szemben az idén megjelent Claude Fable 5 modell mindössze tíz fájlba és bő negyvenezer karakternyi jegyzetet készített, mégis négy jelvényt gyűjtött be a játékban.
Az Anthropic szakemberei szerint azért kerülhetett előnybe a fejlettebb modell, mivel az kizárólag a navigációs stratégiákra, a levont tanulságokra és az aktuális célokra összpontosított a jegyzetkészítés során, elkerülve a játék felületéről amúgy is leolvasható adatok felesleges tárolását.
Az üresjáratokban végzett felülvizsgálat a memóriába csúszott hibák javításában is kulcsszerepet játszik, mivel a tévesen eltárolt adatokat a modellek a későbbi munkamenetek során kész tényként kezelhetnék, amely pontatlan válaszokat eredményezne. Egy másik Pokémon-kísérletben a modell rosszul jegyezte fel az egyik épület elhelyezkedését, ezért onnan kilépve folyamatosan eltévedt, és ugyanabba az akadályba ütközött. Amikor azonban a rendszer egy offline felülvizsgálat során összevetette a jegyzeteit az eredeti naplóval, felismerte a tévedést, frissítette a memóriafájlt, és a javított adatokkal már sikeresen eljutott a következő városba.
Az Anthropic azt is megvizsgálta, hogy ez a módszer képes-e hatalmas dokumentumgyűjteményeket egymással összekapcsolt, wiki-szerű tudásbázisokká alakítani. A kutatók a Stainless szoftvercég mintegy 350 ezer belső dokumentumát – nagyjából 420 millió tokent – adták át a rendszernek, amely 128 munkamenet alatt fokozatosan felépített és finomított egy saját wikit. A tudásbázis felhasználásának köszönhetően a modell teljesítménye egy huszonöt kérdéses teszten 13-ról 48 százalékra javult.
Egy másik, vállalati fúziós és felvásárlási dokumentumokkal végzett kísérletben a Claude a saját wikije segítségével 87 százalékos pontossággal válaszolt a több forrás összekapcsolását igénylő kérdésekre, míg közvetlen dokumentumkereséssel csak 73 százalékot ért el. A háttérben zajló rendszerezés során a modell a gyakran használt adatokat közvetlenül elérhetővé teszi a későbbi munkamenetek számára, a ritkábban szükséges részleteket pedig kereshető fájlokba rendezi.
A módszer ugyanakkor gondos felügyeletet igényel, mivel a memória karbantartása jelentős számítási kapacitást emészt fel, a túl sok információ pedig továbbra is túlterhelheti a rendszert. A kísérletek mindenesetre igazolják, hogy a tudatosabb memóriakezelés révén az AI-ágensek jóval hatékonyabban birkóznak meg a több munkameneten átívelő, bonyolult feladatokkal.
